De flesta som hör talas om server-side tracking får bilden av att det är nästa nivå: finare, säkrare och mer framtidssäkert. Visst finns det flera verkliga fördelar. Men det kostar pengar och är långt ifrån alltid rätt väg. Här går vi igenom vad skillnaden faktiskt är och när det är värt pengarna. Vi förklarar också varför en helt annan lösning, cookieless mätning, ofta löser samma problem bättre och billigare.
Vad är skillnaden, konkret?
Vanlig (client-side) tracking sker i besökarens webbläsare. En tagg laddas på sidan, till exempel Google Analytics via Google Tag Manager. Den samlar in data och skickar den direkt från besökarens enhet till mätverktyget. Så har webbmätning fungerat ända sedan början och det är fortfarande så de allra flesta webbplatser mäter.
Men client-side har med åren stött på problem. Annonsblockerare stoppar taggarna. Webbläsare begränsar hur länge cookies får leva: enligt WebKit, motorn bakom Safari, får cookies som sätts med skript sedan 2019 leva i högst sju dagar. Allt mindre data når därför fram till slutdestinationen. Det gäller GA4, Google Ads, Meta Ads, LinkedIn Ads och andra plattformar som behöver signaler från din webbplats. Server-side tracking växte fram som ett svar på just det. Det är ett sätt att komma runt begränsningarna som client-side successivt råkat ut för. Det är alltså ingen slump att metoden dykt upp nu, eftersom den löser problem som den ursprungliga modellen inte längre klarar lika bra.
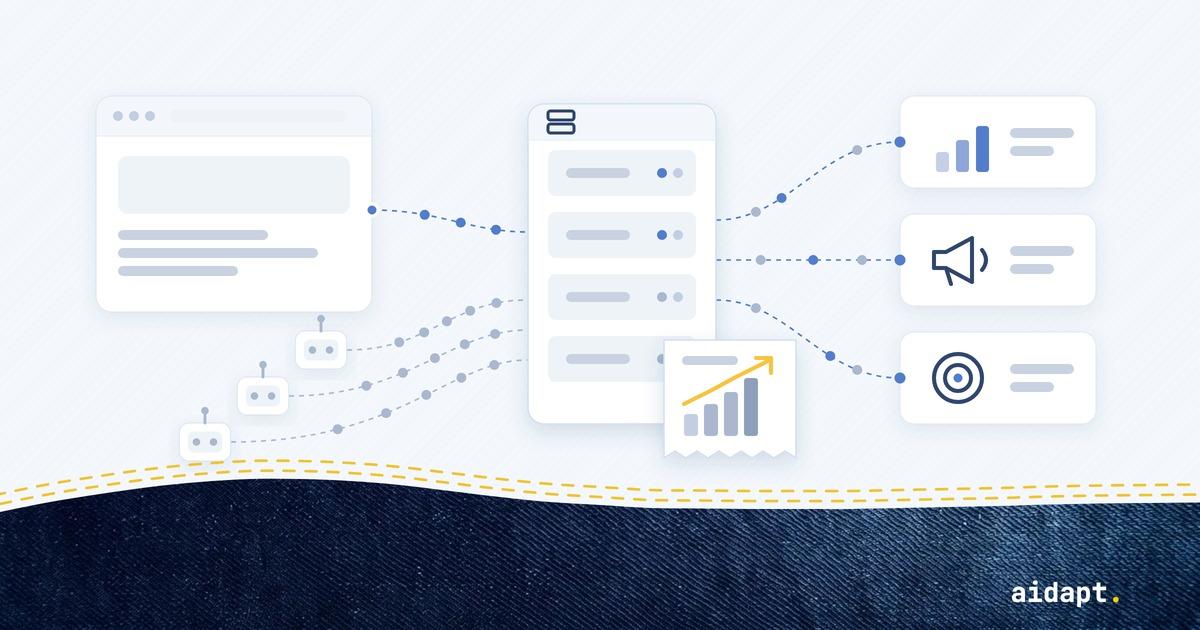
Server-side tracking flyttar ett steg av insamlingen från webbläsaren till en server som du själv kontrollerar. Besökarens webbläsare pratar inte längre direkt med Google, Meta och alla andra. I stället skickas datan först till din egen server-container, som i sin tur skickar den vidare. Besökaren pratar bara med dig.
Det låter som en liten teknisk detalj men öppnar för några saker som client-side inte klarar.
De klassiska fördelarna med server-side
Det finns en anledning till att server-side blivit ett modeord. Fördelarna är verkliga:
Du kontrollerar vilken data som går vidare till plattformarna. När datan passerar din egen server kan du bestämma exakt vilka fält som skickas vidare till varje plattform. Du kan rensa bort personuppgifter, maska IP-adresser och strypa det du inte vill dela. Det ger bättre kontroll ur ett integritets- och GDPR-perspektiv.
Mätningen blir mer motståndskraftig. Annonsblockerare och webbläsarnas spårningsskydd, till exempel Safaris ITP och Firefox spårningsskydd, slår mot taggar som laddas i webbläsaren. En server-side-lösning laddas från din egen domän och träffas oftast inte av samma blockering. Du tappar mindre data.
Längre livslängd på cookies. Cookies som din egen server sätter i sitt svar (first-party) överlever längre än de som sätts med skript. Det förbättrar attributionen, särskilt för återkommande besökare. Det finns dock ett villkor. Enligt analytikern Simo Ahava har WebKit även testat att begränsa sådana cookies till sju dagar när servern ligger på ett annat IP-adressintervall än webbplatsen. Det kan bli fallet när containern körs i molnet. Fördelen kräver alltså att containern sätts upp rätt.
Snabbare sidor. Färre tredjepartsskript i webbläsaren betyder mindre som ska laddas hos besökaren. På tunga sajter kan det märkas.
Så långt det som brukar stå i USP-listan i serverside-broschyren. Nu till det som sällan står där.
När är det värt det och vad kostar det egentligen?
Server-side är inte en inställning du bockar i. Det är en infrastruktur du driftar. Drift kostar löpande, inte bara en gång.
En server-side-container måste köras någonstans, typiskt i molnet hos Google Cloud eller motsvarande. Den kostar per månad och priset följer trafiken. Ju fler besökare och händelser, desto mer processorkraft och bandbredd. Det finns dessutom ett golv. Google rekommenderar minst två serverinstanser i produktion för att minska risken att tappa data vid ett avbrott. Enligt Google är den lägsta kostnaden antalet instanser gånger kostnaden per server, som Google själva anger till ungefär 45 till 50 dollar i månaden. Till det kommer uppsättning, underhåll och felsökning. Du äger nu ett led i kedjan som Google tidigare skötte åt dig.
En grundfråga att ställa sig innan man ger sig in i det: vill jag överhuvudtaget hålla på med drift? För de flesta verksamheter är svaret ett ganska bestämt nej. Drift är varken det man är bäst på eller det man vill lägga sin tid på.
Grovt kan man säga att server-side börjar löna sig när:
- datavolymerna är stora nog att förlorad data från blockering faktiskt kostar pengar i form av sämre annonsoptimering,
- integritetskraven är höga, till exempel i en reglerad bransch där kontroll över exakt vilken data som delas är ett krav och inte en bonus,
- det finns en organisation som kan förvalta uppsättningen över tid.
För en mindre eller medelstor webbplats är den ekvationen sällan given. Vinsten i återvunnen data kan vara några procent, medan kostnaden och komplexiteten märks varje månad. Då är det befogat att fråga sig om pengarna gör mer nytta någon annanstans.
Spam-fällan: en lärdom från kunder med volymberoende tjänster
Här kommer en kostnad som nästan ingen varnar för. Vi har sett den hända på riktigt.
Flera kunder kör sin server-side-mätning via tjänster som tar betalt per bearbetad händelse, alltså en volymberoende prismodell. På mindre webbplatser har kostnaden vid flera tillfällen skjutit i höjden. Orsaken var inte riktig trafik utan spam och bottrafik. Eftersom priset följer antalet anrop betalar du för varje händelse som träffar containern. Botnät, skräprobotar och skanningstrafik bryr sig inte om huruvida besöket är äkta. De skapar händelser, händelserna bearbetas och fakturan växer. I våra kunduppdrag har vi till och med sett lösningar som helt slutat mäta den riktiga trafiken när de slagit i licenstaket. Då var långt över 90 % av händelserna spam.
Det lömska är ansvarsfrågan. I en client-side-värld är skräptrafik mest ett rapporteringsproblem. Du filtrerar bort det i efterhand och det kostar dig inget extra. När mätningen ligger hos en volymberoende tjänst blir samma skräptrafik en direkt rörlig kostnad. Den som håller i driften tar sällan ansvar för att skilja spam från riktig trafik. Det är inte deras uppgift att avgöra vad som är en äkta besökare. De levererar kapacitet. Resultatet blir att du betalar för bottrafik som ingen känner sig ansvarig för att stoppa.
Det går att bygga bort med filter och bot-regler framför containern. Men det är ännu ett lager att sätta upp och underhålla. Det blir ännu en rad i den löpande kostnaden. Poängen är att totalkostnaden för server-side inte går att bedöma utan att ta höjd för skräptrafiken. På mindre sajter är det ofta just den som avgör om det var värt det.
Cookieless tracking: ofta en bättre lösning
Kanske vill du framför allt mäta pålitligt utan att vara beroende av cookies och tredjepartsskript. Då är server-side inte den enda vägen och ofta inte den bästa. Cookieless mätning löser mycket av samma sak utan den tunga infrastrukturen.
Cookieless betyder att mätningen inte sätter några cookies alls och inte identifierar den enskilda besökaren. I stället mäts besöken samlat och anonymt. Det ger flera saker på en gång:
- Ingen cookie-banner som blockerar data. När verktyget varken sparar något i besökarens enhet eller hanterar personuppgifter krävs i många fall inget samtycke. Då mäter du alla besökare, inte bara de som klickar "acceptera". Det är ofta här den stora dataförlusten egentligen sitter, inte i annonsblockerare.
- Enkelt och billigt. Verktyg som klarar cookieless mätning, som Matomo och Piwik PRO, är lätta att sätta upp. De har en förutsägbar kostnad utan molninfrastruktur att drifta.
- Integritet från grunden. Du slipper hela diskussionen om vilken data som delas med vem, eftersom det inte finns någon persondata att dela.
Var gränsen för samtycke går behöver ändå bedömas för varje uppsättning. Europeiska dataskyddsstyrelsen EDPB slog i oktober 2024 fast att även tekniker utan cookies kan omfattas av samtyckesreglerna, till exempel spårningspixlar och spårning som bara bygger på IP-adress. Franska dataskyddsmyndigheten CNIL har ställt upp villkor för när besöksmätning får ske utan samtycke. Både Matomo och Piwik PRO beskriver hur verktygen ställs in för att uppfylla dem. Villkoren gäller i Frankrike men ger en bra bild av vad som brukar krävas.
För många verksamheter är slutsatsen att de inte behöver veta vem den enskilda besökaren är. De behöver veta vad som fungerar: vilka sidor, vilka kanaler och vilka kampanjer som driver resultat. Det svarar cookieless mätning på utan att dra in vare sig cookie-samtycke eller en server-side-container som måste bevakas mot spam.
Vad vi rekommenderar
Server-side tracking är ett starkt verktyg på rätt plats: stora datavolymer, höga integritetskrav och en organisation som kan förvalta det. Men det är ingen standardåtgärd och framför allt ingen gratis uppgradering. Driften är en löpande och volymberoende kostnad som spam kan göra omöjlig att förutse. Ansvaret för att skilja riktig trafik från skräp hamnar dessutom lätt mellan stolarna.
I de flesta fall rekommenderar vi i stället att köra cookieless mätning parallellt med den befintliga uppsättningen, inte som en ersättare. GA4 och övriga plattformar får fortsätta göra sitt för den samtyckande trafiken och annonsoptimeringen. Samtidigt fångar den cookieless mätningen upp helheten vid sidan om: alla besökare, även de som nekar cookies eller blockerar skript. Du får då två bilder som kompletterar varandra. Den ena är detaljerad men ofullständig (GA4). Den andra är anonym men heltäckande (cookieless). Tillsammans ger de en sannare bild av vad som faktiskt händer på sajten än någon av dem gör ensam.
Innan man går den vägen är det värt att fråga sig vad man egentligen vill veta. Är cookieless mätning det smartare sättet att ta reda på det? Oftare än man tror är svaret ja.
Vill du veta vilken mätning som passar din verksamhet hjälper vi dig att räkna på det, med kostnaderna synliga.
Källor
- WebKit, Full Third-Party Cookie Blocking and More, 24 mars 2020. Om sjudagarstaket för cookies som sätts med skript (sedan februari 2019). https://webkit.org/blog/10218/full-third-party-cookie-blocking-and-more/
- Simo Ahava, First-party cookies and WebKit revisited, 14 november 2022. Om begränsningen för cookies från servrar på ett annat IP-adressintervall. https://www.simoahava.com/privacy/first-party-cookies-webkit-revisited/
- Google, Set up server-side tagging with Cloud Run. Rekommendationen om minst två instanser och kostnaden per server. https://developers.google.com/tag-platform/tag-manager/server-side/cloud-run-setup-guide
- Google, Planning infrastructure requirements and costs, uppdaterad 9 oktober 2024. Om lägsta kostnad och pris per instans. https://developers.google.com/tag-platform/learn/sst-fundamentals/7-planning-infrastructure
- EDPB, Guidelines 2/2023 on Technical Scope of Art. 5(3) of ePrivacy Directive, version 2.0, antagen 7 oktober 2024. https://edpb.europa.eu/system/files/2024-10/edpb_guidelines_202302_technical_scope_art_53_eprivacydirective_v2_en_0.pdf
- CNIL, Sheet n°16: Use analytics on your websites and applications, 11 juni 2020. https://www.cnil.fr/en/sheet-ndeg16-use-analytics-your-websites-and-applications
- Matomo, How do I configure Matomo without tracking consent for French visitors (CNIL exemption)? https://matomo.org/faq/how-do-i-configure-matomo-without-tracking-consent-for-french-visitors-cnil-exemption/
- Piwik PRO, Audience measurement without consent: how to set up Piwik PRO to comply with CNIL guidelines. https://piwik.pro/cnil-exemption